
苏诺之音 V1.2 发布:攻克初代中文人声合成,支持拼音韵母对齐与 60 秒主副歌生成
苏诺之音(https://www.suno.cn/)正式发布 V1.2 版本升级,迎来平台在中文 AI 歌唱合成领域的重大突破。针对传统多模态模型在处理中文唱歌时容易出现的平仄跑调、声调与旋律走向冲突(倒字)等痛点,团队自研了拼音韵母对齐管线,首次支持输入中文歌词一键生成 60 秒带人声演唱的完整主副歌小样。
自研声学发音对齐层
将汉字切分为声母、介母与韵母音素,使发音时长与小节强弱拍精准吻合。
单次生成时长翻倍
从初代 30 秒动机扩容至 60 秒,完整容纳一段主歌与一段副歌的情绪递进。
双基础唱腔音色开放
提供清亮流行女声与磁性温暖男声两套基础声线,满足抒情流行创作需求。
一、 攻克中文 AI 歌唱最大难关:为什么说“防倒字”是母语级写歌的底线?
汉语作为典型的声调语言,拥有阴平、阳平、上声、去声四个声调。在传统歌曲创作中,“字正腔圆”要求旋律走向尽量契合字音的声调走向;如果旋律上行而字音声调本应下行,就会产生俗称的“倒字”(例如将“水饺”唱成“睡觉”)。
在 V1.2 版本中,苏诺之音构建了本地歌唱音素解码器,在文字转音频(Text-to-Audio)的潜在表征空间中引入汉语音素边界约束,确保 AI 歌手在演唱流行、民谣歌曲时咬字更清晰自然。
V1.2 歌词到人声歌曲的合成路径
在创作界面输入带有 [Verse](主歌)与 [Chorus](副歌)段落标记的歌词。
解析引擎自动标注汉字拼音韵母,并基于十三辙押韵表推断尾音拖腔时长。
声学模型根据调式走向约束音高波动,抑制逆向倒字发音。
融合伴奏音轨与干声音色,一次性输出带人声演唱的完整成品音频。
二、 主副歌元标签支持与双声线体验
伴随人声能力的上线,V1.2 首次引入了标准音乐元标签支持。创作者可以在歌词框中自由使用 [Verse]、[Chorus]、[Outro] 标签,指导模型自适应区分叙事主歌的轻声诉说与高潮副歌的放声吟唱。
| 功能特性 | V1.0 初代实验室 (2023.03) | V1.2 人声突破版 (2023.06) |
|---|---|---|
| 生成内容形态 | 仅支持纯音乐旋律与乐器伴奏 | 全面支持带中文人声演唱的流行歌曲小样 |
| 最长生成时长 | 30 – 45 秒旋律动机 | 最长 60 秒,完整容纳主歌 + 副歌 |
| 歌词解析机制 | 仅解析风格/配器关键词 | 音素级韵母对齐 + 标准 [Verse]/[Chorus] 结构识别 |
| 声线风格选择 | 无演唱声线 | 提供清澈流行女声与温暖叙事男声两类基础质感 |
三、 技术规格与早期创作者回响
V1.2 的发布让苏诺之音从“纯音乐伴奏工具”正式迈入“AI 虚拟歌手创作”新阶段。虽然这一时期的音质仍在 24kHz 采样率区间,但已经吸引了大量网络作词爱好者将搁置在备忘录里的歌词直接变为可以播放的歌曲。
V1.2 人声歌唱引擎规格
版本更新常见问答
怎么用中文歌词生成带有主副歌的完整歌曲?
在输入歌词时,只需在歌词段落前加上 [Verse](主歌)和 [Chorus](副歌)标签,AI 就会根据结构自动规划前面的平静叙述与副歌高潮的旋律拉升。
为什么早期中文 AI 唱歌有时会听不清某些字的读音?
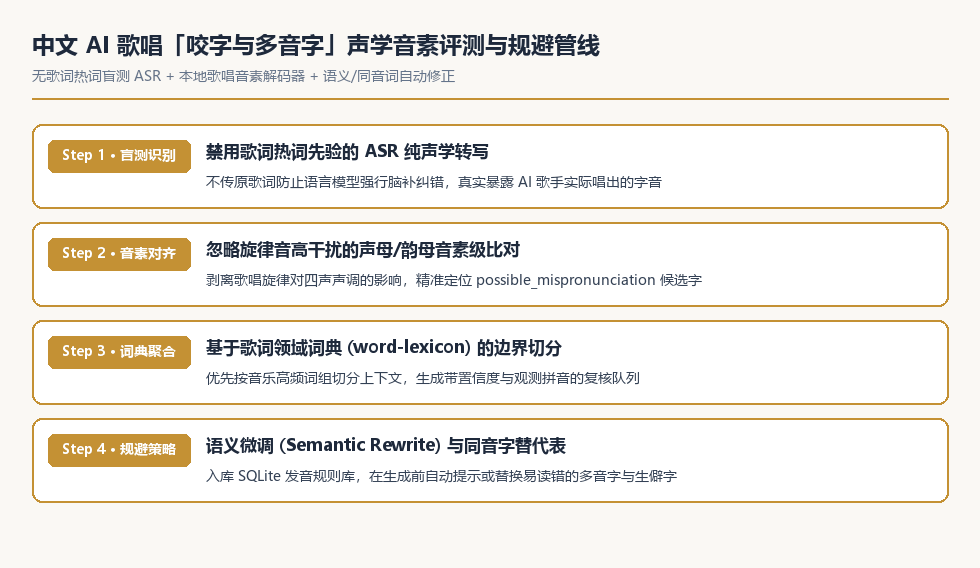
早期语音合成模型常直接按字符预测波形,容易受高频打击乐器掩盖;V1.2 引入韵母音素对齐后大幅改善了这一现象,后续更升级为无热词 ASR 盲测与词典级防倒字管线。
进入苏诺之音在线工作台,体验自研苏诺 V5 / V6 音乐生成与 AI MV 2.0 智能分镜导演能力。