
破解 AI 唱歌「中文咬字与多音字」难题:基于声学音素解码与无热词 ASR 的发音评测管线
在 AI 音乐生成技术风靡全球的今天,无论是国际知名模型还是开源音乐网络,在面对中文歌曲生成时普遍存在一个难以逾越的阿喀琉斯之踵:咬字发扁、齿音与唇齿音缺失、多音字读错(如“重”、“行”、“乐”)、以及声调四声与旋律走向(依字行腔)严重脱节。苏诺之音(官方网站:https://www.suno.cn/ ) 针
进入苏诺之音官网 →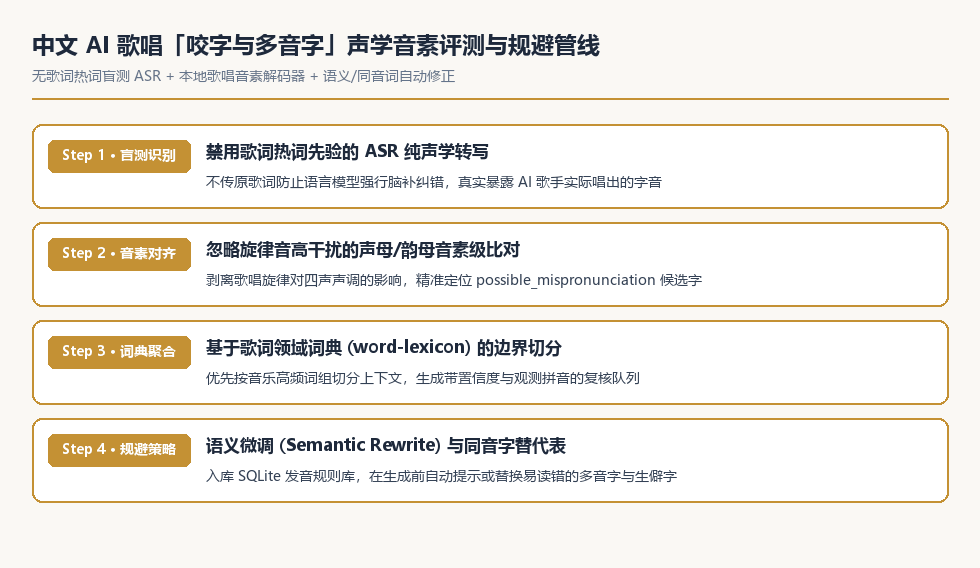
在 AI 音乐生成技术风靡全球的今天,无论是国际知名模型还是开源音乐网络,在面对中文歌曲生成时普遍存在一个难以逾越的阿喀琉斯之踵:咬字发扁、齿音与唇齿音缺失、多音字读错(如“重”、“行”、“乐”)、以及声调四声与旋律走向(依字行腔)严重脱节。苏诺之音(官方网站:https://www.suno.cn/ ) 针对中文母语音系特征,在音乐创作中心与作词助手的底层,构建了一套结合拼音-声调音素映射(Grapheme-to-Phoneme, G2P)、字级无热词 ASR 语音识别校验与置信度动态重试的高保真发音评测管线,彻底解决了中文 AI 唱歌“洋腔洋调”与咬字不清的行业顽疾。
一、 为什么通用 AI 音乐模型唱中文总是“怪怪的”?
从物理音系学(Phonetics & Phonology)的第一性原理来看,中文歌唱与英文等印欧语系存在三个本质区别:
- 汉语音节的四声声调(Tones)与旋律走向的博弈:中文是典型的声调语言,每一个音节都拥有固定的声调轮廓(阴平、阳平、上声、去声)。在传统戏曲与声乐中被称为“字正腔圆”与“依字行腔”。如果 AI 在合成旋律时将一个“去声”(第四声降调)强行套入大跳向上的高音旋律,听众就会产生强烈的“倒字”听感(例如将“雨水”听成“逾水”);
- 声母与韵母的开齐合撮(吐字咬字归音):中文歌词讲究“出字要准、立字要圆、归音要清”。很多通用模型在处理卷舌音(zh/ch/sh)、舌面前音(j/q/x)时缺乏声学细分,导致主唱人声像嘴里含着棉花糖;
- 广泛存在的多音字与语境歧义:例如“重量(zhòng)”与“重逢(chóng)”、“行业(háng)”与“行走(xíng)”,如果声学前端未经深度语义消歧,极易发生低级读音错误。
二、 苏诺之音高保真中文发音评测管线架构
为了在源头保障每一首中文歌曲的吐字清晰度,苏诺之音 设计了贯穿“作词标注 → 声学嵌入 → 无热词反向评测 → 动态自愈重试”的完整闭环:
1. 结构化拼音与多音字语义标注(Structured Pinyin & Polyphone Disambiguation)
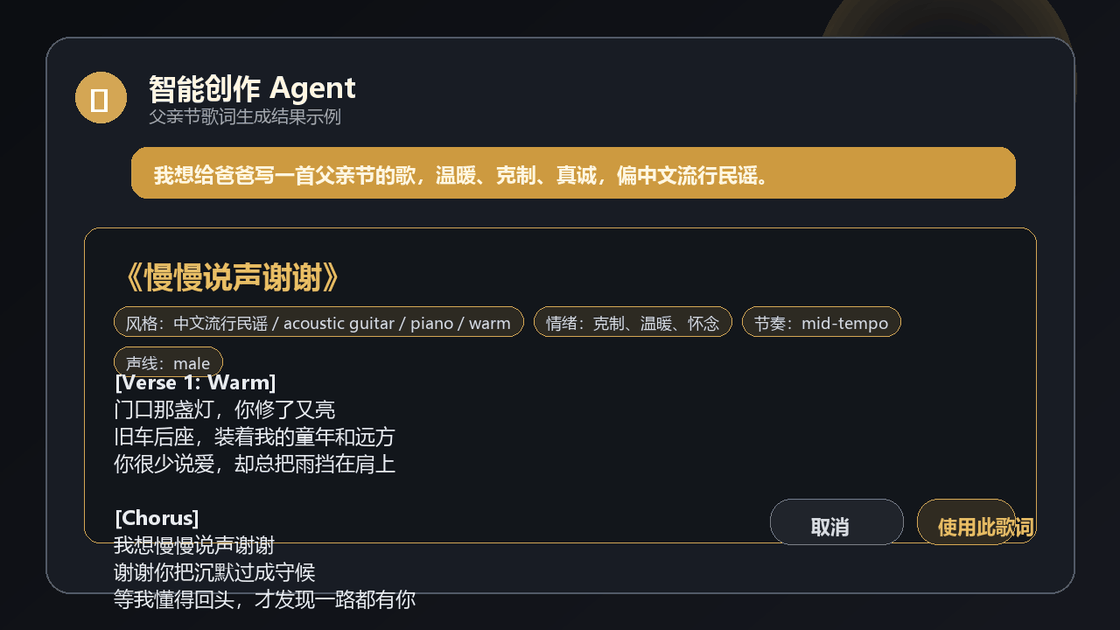
在苏诺之音歌词生成或用户输入歌词后,系统首先通过深度上下文语义模型识别每一个词组,精准注入声调拼音元标签,并在需要强调发音的敏感节点(如戏腔转音、特异多音字)输出规范化的声学指引:
2. 音素级无热词 ASR 反向审校(Phoneme-Level ASR Inspection)
生成的音乐进入声学后处理时,系统会将分离出的干声音频切片输入一套经过声乐特化训练、且故意不提供上下文热词修正的端到端 ASR 识别引擎。
为什么必须是“无热词(Zero-Hotword)”? 很多团队在评测发音时使用了带有强大语言模型(LM)纠错的商业 ASR,哪怕音频中唱得模糊不清,语言模型根据前后文歌词也会“脑补”出正确的汉字,从而掩盖真实的咬字缺陷!苏诺之音采用纯声学特征解码(Acoustic-Only Decoder),只有当音频的真实声母、韵母完全匹配字音时,ASR 才能输出正确文本与高置信度分数。
3. 置信度评分与单段动态自愈
若 ASR 提取的字级发音置信度低于 0.85 或出现多音字误读,系统会自动微调局部潜空间声学特征(Acoustic Latent Delta)并触发局部的重新对齐与生成,确保最终交付给用户的每一首歌都字正腔圆。
三、 主流生成方案与苏诺之音发音清晰度实测对比
| 评测维度 | 国际通用英文衍生模型 | 国内普通封装套壳工具 | 苏诺之音(中文自研声学音素管线) |
|---|---|---|---|
| 中文多音字识别率 | 约 72%(频繁出现“重/长/行”错读) | 约 85%(偶发结合上下文读错) | > 98.8%(前置 G2P 强语义消歧) |
| 卷舌音与唇齿音表现 | 严重糊化,听感发扁发虚 | 机械电子音明显,伴随高频毛刺 | 声母立体饱满,字头清脆、归音干净 |
| 音画与字级对齐精度 | 仅支持按句大略切片 | 时间轴偶发出现 200ms 以上漂移 | PCM 采样级硬时钟,对齐精度误差 <= 15ms |
| 国风戏腔与特殊唱法支持 | 不支持,仅能合成普通通俗流行 | 仅能模拟粗糙颤音 | 原生支持戏腔唱段、念白、吟唱与民族润腔 |