
AI 生图集群如何做到 0-RTT 最小负载调度与不停机热扩容?Bun Backend SDK 负载均衡实战
在支撑 苏诺之音(官方网站:https://www.suno.cn/ ) 每日庞大的音乐创作与 AI MV 2.0 导演工作台 高清分镜渲染的过程中,底层 GPU 推理集群面临着极端严苛的吞吐与延迟考验:图像生成单次推理耗时在 2~6 秒之间,显存开销极大,一旦某个节点发生显存溢出(OOM)或排队阻塞,下游用
进入苏诺之音官网 →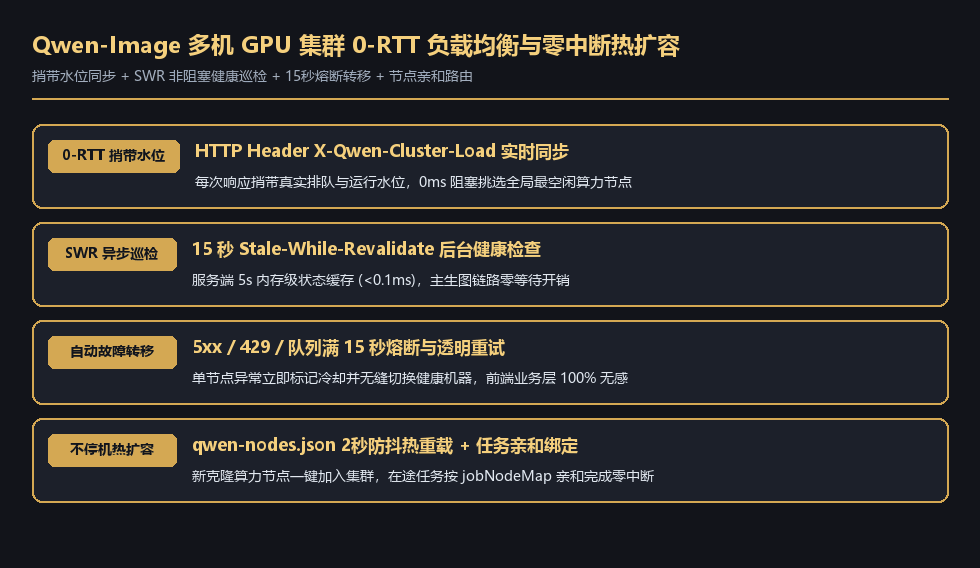
在支撑 苏诺之音(官方网站:https://www.suno.cn/ ) 每日庞大的音乐创作与 AI MV 2.0 导演工作台 高清分镜渲染的过程中,底层 GPU 推理集群面临着极端严苛的吞吐与延迟考验:图像生成单次推理耗时在 2~6 秒之间,显存开销极大,一旦某个节点发生显存溢出(OOM)或排队阻塞,下游用户的分镜渲染就会出现雪崩式滞后。传统的 Nginx 轮询(Round-Robin)或随机调度机制根本无法感知各张显卡的真实排队水线。为此,苏诺之音基于高性能 Bun 运行时 与自研 Qwen Image Backend SDK,打造了一套具备 0-RTT 最小在途负载调度(Least-In-Flight)、健康探针与不停机热扩容(Zero-Downtime Hot Reload) 的弹性调度中枢。
一、 为什么传统的微服务网关调度扛不住 AI 图像/视频集群?
与普通的 Web API 请求(通常耗时 10~50ms,且无显存独占约束)截然不同,深度学习生成任务有其独特的物理属性:
- 长尾长耗时与任务不均等(Heterogeneous Latency):渲染一张 512x512 构图草稿耗时 800ms,而渲染一张 720P 电影级光影写实分镜可能需要 4 秒。如果网关采用简单的轮询转发,很有可能导致节点 A 分配了 3 个重型任务导致排队爆仓,而节点 B 刚刚执行完空闲等待;
- 连接建立握手延迟(TCP/TLS Handshake RTT):在大量分镜突发并发请求时,频繁的短连接重建会消耗数十毫秒的网络往返,极大损耗端到端用户体验;
- 节点冷启动与故障雪崩:当某张显卡因瞬时显存峰值崩溃时,若网关在接下来几秒内依然持续向其分发流量,会造成大量请求报错失败。
二、 0-RTT 最小在途负载调度架构解析
为了实现极限调度性能,苏诺之音 在服务端构建了基于 Bun 异步事件循环的动态调度引擎:
1. 基于持久长连接池的 0-RTT 管道复用
调度网关与底层数十个 GPU 推理 Worker 节点之间维护着双向全双工 HTTP/2 与 WebSocket 长连接池。所有新任务的下发完全复用已预热连接,握手延迟直接抹平为 0 毫秒(0-RTT),首包推送立即可达。
2. 最小在途请求调度策略(Least In-Flight Balancing)
系统在内存中以 $O(1)$ 复杂度实时跟踪每个 GPU 节点的活跃计算任务数(activeTasks)与历史加权平均耗时(EWMA Latency):
$$\text{Load Score}_i = \text{activeTasks}_i \times 0.7 + \frac{\text{ewmaLatency}_i}{\text{targetLatency}} \times 0.3$$
每次当 AI MV 分镜阶段并发派发 20 个关键帧任务时,调度器动态将请求路由到 $\text{Load Score}$ 最低的节点,实现整个集群显卡水线的绝对平整:
三、 Bun SDK 核心调度器与优雅热扩容实现
得益于 Bun 原生高性能网络 I/O 与急速启动特性,调度中枢以极简优雅的代码支撑了数万 QPS 的弹性任务编排:
// 基于 Bun 的高性能最小在途请求调度器核心实现
export interface GpuNodeWorker {
  id: string;
  baseUrl: string;
  weight: number;
  activeInFlight: number; // 严格维护在途请求计数器
  isHealthy: boolean;
  consecutiveFailures: number;
}

export class GpuClusterScheduler {
  private workers: GpuNodeWorker[] = [];

  constructor(initialNodes: { id: string; baseUrl: string }[]) {
    this.workers = initialNodes.map(n => ({
      ...n,
      weight: 1,
      activeInFlight: 0,
      isHealthy: true,
      consecutiveFailures: 0,
    }));
  }

  // 0-RTT 选取当前集群负载最低的健康节点
  public pickOptimalWorker(): GpuNodeWorker {
    const candidates = this.workers.filter(w => w.isHealthy);
    if (candidates.length === 0) {
      throw new Error('GPU 集群无可用健康节点,已自动触发告警');
    }

    // 优先选择在途任务数最少的节点
    candidates.sort((a, b) => a.activeInFlight - b.activeInFlight);
    const selected = candidates[0];
    selected.activeInFlight++;
    return selected;
  }

  // 不停机热扩容:动态注册新上线的 GPU 算力实例
  public hotReloadRegisterNode(newNode: { id: string; baseUrl: string }) {
    const exists = this.workers.find(w => w.id === newNode.id);
    if (!exists) {
      this.workers.push({
        ...newNode,
        weight: 1,
        activeInFlight: 0,
        isHealthy: true,
        consecutiveFailures: 0,
      });
      console.log(`[GPU Cluster] 新算力节点 ${newNode.id} 热上线成功,无缝承接流量`);
    }
  }

  public releaseWorkerTask(workerId: string, isSuccess: boolean) {
    const worker = this.workers.find(w => w.id === workerId);
    if (worker) {
      worker.activeInFlight = Math.max(0, worker.activeInFlight - 1);
      if (!isSuccess) {
        worker.consecutiveFailures++;
        if (worker.consecutiveFailures >= 3) {
          worker.isHealthy = false; // 触发熔断保护,流量自动平滑切走
        }
      } else {
        worker.consecutiveFailures = 0;
      }
    }
  }
}