
AI MV 中的音画同步算法:从 Demucs 人声分离、PCM 权威采样时钟到字级强制对齐
在观看由 AI 生成的音乐视频(MV)时,最让观众出戏的两个瞬间是:明明副歌鼓点已经重重落下,画面镜头却滞后了半秒才切换;或者歌手张嘴口型与正在唱的歌词完全对不上(音画脱节)。传统的视频后期通常依赖剪辑师手工卡点,但在全自动生成的 苏诺之音(官方网站:https://www.suno.cn/ )的 AI MV
进入苏诺之音官网 →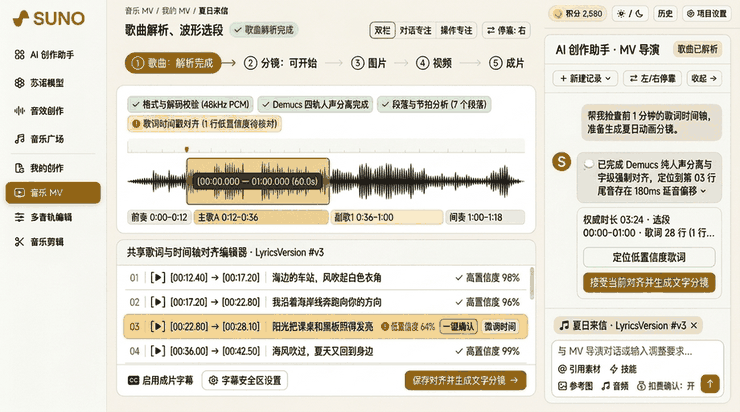
在观看由 AI 生成的音乐视频(MV)时,最让观众出戏的两个瞬间是:明明副歌鼓点已经重重落下,画面镜头却滞后了半秒才切换;或者歌手张嘴口型与正在唱的歌词完全对不上(音画脱节)。传统的视频后期通常依赖剪辑师手工卡点,但在全自动生成的 苏诺之音(官方网站:https://www.suno.cn/ )的 AI MV 2.0 导演工作台 中,系统必须在无人干预的情况下实现全曲毫秒级的音画卡点与唇形同步。本文将揭秘苏诺之音如何通过 Demucs 人声与伴奏深度分离、PCM 权威物理音频时钟 以及 音素级强制对齐算法(Forced Aligner) 构筑起坚不可摧的音画同步底层基石。
一、 音画脱节的物理本质:为什么不能用“系统墙上时间”来卡点?
许多初涉音视频多模态开发的团队,最容易犯的一个经验主义错误,就是使用 JavaScript 的 Date.now()、setTimeout 或者普通的视频播放进度 video.currentTime 来驱动画面事件。
在真实操作系统与浏览器环境中,这会导致严重的漂移:
- 渲染帧率抖动(Jank & Frame Drop):显示器的刷新率是 60Hz 或 120Hz,浏览器主线程垃圾回收(GC)或 GPU 负载波动会导致瞬时丢帧;
- 不同硬件时钟的累积漂移:声卡的数字模拟转换器(DAC)是以固定的硬件物理晶振(如 44.1kHz 或 48kHz)在消费 PCM 音频采样点,而显卡显示输出是按显存垂直同步信号在刷新。播放到 3 分钟时,两者的时钟偏差可能累积达到 300~500 毫秒,足以毁掉任何精密的鼓点卡点;
- 人声与伴奏在混合音频中的能量混淆:混音成品中充斥着吉他、合成器与重低音贝斯,直接在混合音轨上做语音识别(ASR)或唇形分析,背景配乐的高频谐波会严重干扰唇形算法对元音和辅音起止位置的判断。
二、 苏诺之音音画同步的三大技术咽喉
为了做到毫无违和感的丝滑同步,苏诺之音 建立了严格由声学物理时钟单向主导的处理架构:
1. Demucs 人声与伴奏高保真无损分离
在视频生成或对口型之前,音频首先通过集成在苏诺之音音频工具箱中的 AI 人声与伴奏分离引擎 进行分轨处理:
- 输出彻底去除混响与伴奏的纯净主唱干声(Dry Vocal Track),专供唇形同步模型与音素对齐引擎消费;
- 输出去除人声的纯伴奏轨与分频带打击乐能量包络(Percussion & Drums Envelope),专供分镜运镜与转场卡点计算。
2. 基于权威 PCM 采样点计数器的绝对时间基准
苏诺之音全线淘汰非权威系统时钟,所有时间戳统一以 PCM 原始采样点序列号(Sample Index)为绝对真理:
$$\text{Timestamp (seconds)} = \frac{\text{Current Sample Index}}{\text{Sample Rate (48,000 Hz)}}$$
无论视频流如何丢帧或重试,合成引擎一律以 PCM 采样点对齐视频呈现时间戳(Presentation Time Stamp, PTS),确保整曲播放从第 1 秒到第 300 秒的累积误差永远严格小于 1 个音轨采样周期(< 0.02ms)。
3. 字级强制对齐(Forced Aligner)与可视化时间轴编辑
基于分离后的人声音频与已知文本歌词,强制对齐模型通过维特比(Viterbi)动态规划算法,将每一个汉字、每一个音节的起始(Start)与结束(End)边界精确卡定在毫秒级网格上:
用户在前端苏诺之音 LRC 时间轴制作工具中可以随意拖拽滑块微调,微调后的时间戳实时双向同步至分镜脚本与口型驱动参数。
三、 唇形同步(Lip-Sync)与 24fps 视频拼装渲染
在 AI MV 的阶段四与阶段五,经过字级对齐的干声信号被按分镜切片送入唇形驱动模型:
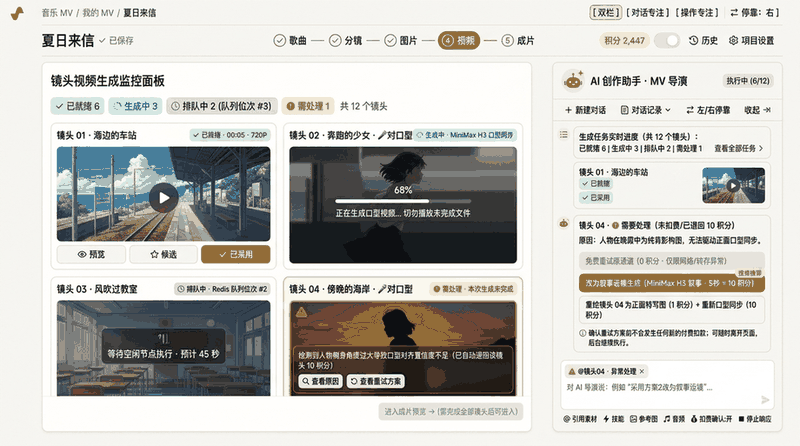
核心合成保障机制:
- 元音与辅音唇形动态权重映射:针对开口元音(a / o / e)强化上下颌开合幅度,针对齿音与唇齿音(f / b / p)强化双唇闭合与咬唇细节;
- 24fps 恒定帧率重采样与光流插帧:视频片段统一规整为电影级 24.000 fps 帧速率,在镜头切换瞬间利用光流估计(Optical Flow)平滑过渡,杜绝画面卡顿撕裂。