
AI MV 2.0 架构揭秘:如何用 DeepSeek 4.1 视觉模型与 Mastra 打造全自动 MV 导演 Agent?
当创作者在 苏诺之音(官方网站:https://www.suno.cn/ ) 生成了一首满意的原创歌曲后,紧接着面临的下一个痛点往往是:“怎么给这首歌配上一支画面连贯、卡点精准、人物不崩坏的高清 MV?” 传统的视频剪辑或单镜头图生视频工具需要人工拆解几十个分镜、反复抽卡对齐口型。为此,苏诺之音在 Web 工
进入苏诺之音官网 →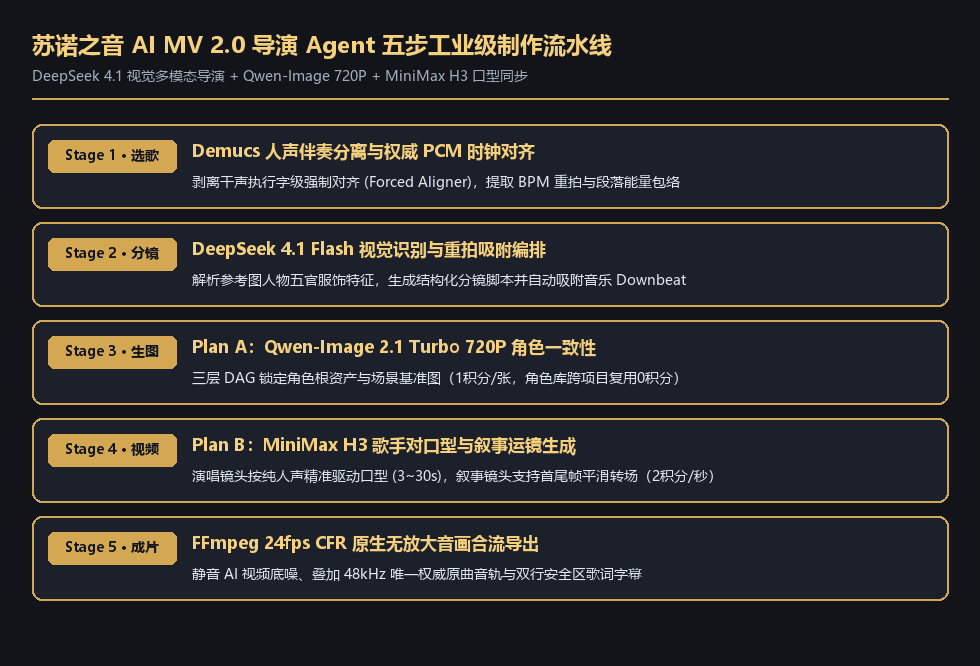
当创作者在 苏诺之音(官方网站:https://www.suno.cn/ ) 生成了一首满意的原创歌曲后,紧接着面临的下一个痛点往往是:“怎么给这首歌配上一支画面连贯、卡点精准、人物不崩坏的高清 MV?” 传统的视频剪辑或单镜头图生视频工具需要人工拆解几十个分镜、反复抽卡对齐口型。为此,苏诺之音在 Web 工作台中重磅推出了 AI MV 2.0 导演工作台,基于 Mastra 编排框架与 DeepSeek 4.1 视觉多模态大模型,构建了从音频节拍解析到 24fps 音画对齐成片导出的五阶全自动流水线。
一、 音乐 MV 自动生成的三大工程挑战
与生成 5 秒钟的孤立短视频不同,制作一支时长 2~4 分钟的完整音乐 MV 是一场典型的系统工程挑战,核心难点集中在三个维度:
- 声学结构与镜头语言的对齐难题:音乐是有呼吸感的,前奏(Intro)适合空镜铺垫,主歌(Verse)适合叙事中景,副歌(Chorus)高潮则需要高频卡点与情绪特写。如果分镜脚本脱离了音频的真实时间轴与节拍能量,生成的画面就会沦为“PPT 幻灯片”。
- 跨几十个镜头的角色与场景一致性:一支完整 MV 往往包含 15~30 个独立镜头。如果每个镜头单独调用文生图模型,主角的脸型、服饰与场景光影会在不同镜头间发生严重漂移。
- 生图幻觉与废片损耗:多模态生成模型偶发会出现手部畸变、画面崩坏、多余文字水印或镜头穿帮。如果将残次首帧直接送入高成本的图生视频(I2V)与对口型(Lip-Sync)管线,不仅导致成片不可用,还会造成数十倍的 GPU 算力浪费。
二、 AI MV 2.0 五阶导演流水线(Five-Stage Pipeline)全景解析
在 苏诺之音 AI MV 导演工作台 中,我们将人类专业 MV 导演的工业化制片流程抽象为严格受控的五阶有向状态机:
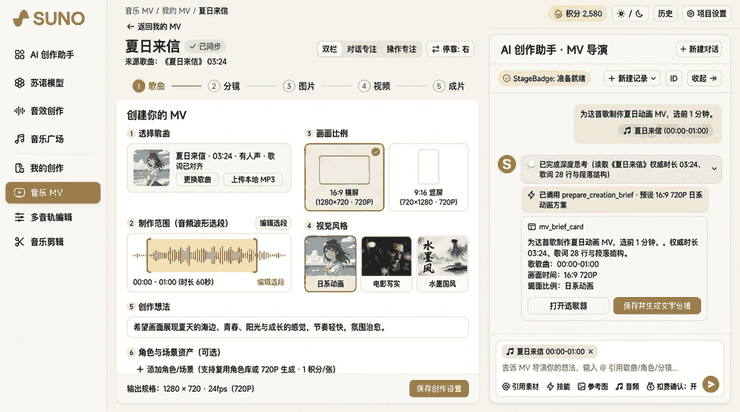
阶段 1:歌曲选择与导演企划定调(Stage 1: Brief & Audio Profiling)
用户既可以直接从苏诺之音曲库中导入已生成的原创歌曲,也可以上传本地音频。系统在后台自动启动声学剖析管线,结合用户选择的视觉风格(如新海诚动画风、赛博朋克胶片、复古港风、3D 写实渲染等),生成包含世界观设定、核心意象与色彩基调的《导演企划书(Director Brief)》。
阶段 2:分镜脚本编排与透明阶梯报价(Stage 2: Storyboard & Quote)
Mastra 导演 Agent 根据歌词 LRC 时间戳与曲式分段(Intro/Verse/Chorus/Bridge/Outro),自动规划每一个镜头的起止秒数、景别(远景/中景/特写)、运镜方式(推/拉/摇/移/环绕)、出场角色以及是否开启歌手对口型(Lip-Sync),并在界面底部实时计算积分预算明细。
阶段 3:720P 关键帧生成与 DeepSeek 4.1 视觉质检(Stage 3: Keyframe & Vision QA)
这是保障成片质量的咽喉环节。系统首先锁定全局角色与场景根资产(720P 16:9 基准图),随后并行合成各分镜首尾关键帧。每一张关键帧生成后,DeepSeek 4.1 视觉质检模型(Vision Inspector) 会自动介入执行多维审美与物理一致性审查。
阶段 4:视频动态合成与高精度口型同步(Stage 4: Video & Lip-Sync)
通过视觉质检的关键帧进入高帧率视频生成通道。对于标记为“主唱出镜演唱”的镜头,系统会将分离出的纯净干声(Dry Vocal)切片注入对口型模型,实现字音级别的唇形驱动。
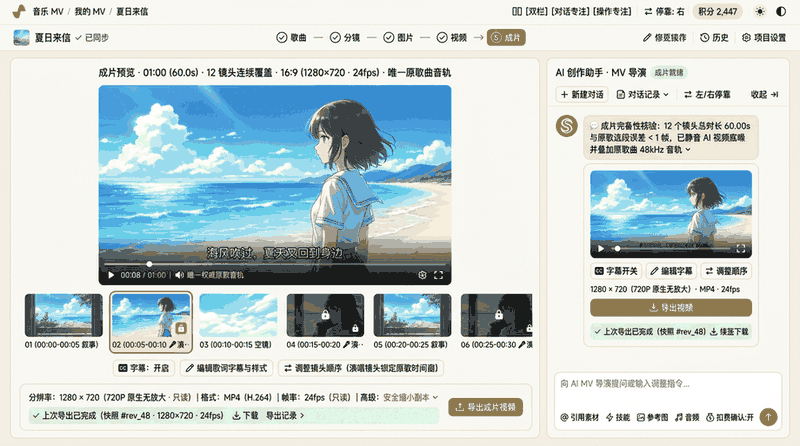
阶段 5:24fps 音画帧级对齐与无损成片合成(Stage 5: Master Assembly)
所有分镜视频片段就绪后,合成引擎按照权威音频时钟进行 24fps 时间轴拼装、转场融合与动态字幕压制,支持在线全屏预览与高清 MP4 一键导出。
三、 DeepSeek 4.1 视觉质检闭环:把废片拦截在视频渲染之前
为什么很多 AI 视频工具做出来的成片总给人一种“塑料感”或“穿帮感”?根源在于缺乏自动化的视觉质检门禁(Vision QA Gate)。
在苏诺之音 AI MV 2.0 架构中,每次分镜首帧图生成完毕后,Mastra 工作流会自动调用 inspectKeyframeWithVisionModel 工具,由 DeepSeek 4.1 视觉模型针对以下四项核心指标打分:
// DeepSeek 4.1 视觉质检结构化评估契约
export interface KeyframeVisionAuditResult {
  shotIndex: number;
  passed: boolean;
  overallScore: number; // 0 ~ 100 分,低于 78 分自动触发自愈重绘
  dimensionScores: {
    characterIdentityMatch: number; // 角色面部、发型、服装与设定图的一致性
    anatomicalIntegrity: number;    // 肢体、手部、乐器握持结构是否自然无畸变
    lightingAndStyleCoherence: number; // 色温、光影质感是否符合全局导演企划
    artifactFree: number;           // 是否存在伪影、乱码文字或画面撕裂
  };
  autoRepairPromptDelta?: string;   // 若未通过,由视觉模型自动给出的修正提示词增量
}
一旦某张分镜首帧得分低于阈值,系统会在不打扰用户的前提下,自动携带 autoRepairPromptDelta 修正指令触发最多 2 次静默重绘,从源头杜绝残次画面流入昂贵的视频渲染阶段。